
Go-bufio
附件文档全文(Go bufio )#
Go语言 bufio 包功能用法及核心概念详解
你想要详细了解Go语言中bufio包的功能、用法和核心概念,我会从基础到进阶,用通俗易懂的方式为你讲解这个高频使用的标准库包。
bufio(buffered I/O)是Go标准库中对io包的缓冲增强封装,它在底层io.Reader/io.Writer之上增加了缓冲区,避免频繁的系统调用,大幅提升I/O操作的性能(尤其是小数据量、高频次读写场景)。
简单类比:直接用io包读写就像每次接水都接一杯就倒,频繁往返;而bufio就像先接满一桶水,再慢慢倒,减少往返次数。
bufio的核心分为三大类组件,对应不同的I/O场景:
- Reader:带缓冲的读取器
- Writer:带缓冲的写入器
- Scanner:简化的按行/按分隔符读取器(基于Reader封装)
通过bufio.NewReader创建,需传入一个基础的io.Reader(如os.File、strings.Reader、net.Conn等):
Go |
方法 | 功能 | 适用场景 |
ReadByte() | 读取1个字节 | 逐字节读取 |
ReadRune() | 读取1个Unicode字符(处理多字节字符) | 读取中文等多字节文本 |
ReadString(delim byte) | 读取到指定分隔符(包含分隔符) | 按自定义分隔符读取(如按逗号、换行符) |
ReadLine() | 读取一行(不包含换行符,低级别方法) | 底层实现,一般用ReadString('\n')替代 |
ReadBytes(delim byte) | 读取到指定分隔符,返回[]byte | 二进制数据按分隔符读取 |
Peek(n int) | 预览前n个字节(不移动读取指针) | 提前判断数据格式 |
Read(p []byte) | 读取数据到切片(兼容io.Reader) | 批量读取 |
Go |
通过bufio.NewWriter创建,传入基础io.Writer:
Go |
方法 | 功能 | 注意事项 |
Write(p []byte) | 写入字节切片到缓冲区 | 不立即刷盘 |
WriteString(s string) | 写入字符串到缓冲区 | 最常用,简化字符串写入 |
WriteByte(c byte) | 写入单个字节 | 逐字节写入 |
WriteRune(r rune) | 写入单个Unicode字符 | 处理多字节字符 |
Flush() | 刷新缓冲区:将缓冲区数据写入底层Writer | 必须调用!否则数据可能丢失 |
Available() | 返回缓冲区剩余可用空间 | 判断是否需要手动Flush |
Buffered() | 返回缓冲区中未刷新的字节数 | 监控缓冲区状态 |
Go |
关键注意点:如果不调用Flush(),当缓冲区未满时,数据会一直留在内存中,程序退出后数据丢失!建议在defer中调用Flush():
Go |
Scanner是bufio中更易用的读取器,专门用于按“块”读取数据(默认按行),封装了bufio.Reader,适合快速实现按行/按自定义分隔符读取。
Go |
Scanner支持通过Split方法自定义分割规则,内置的分割函数有:
- bufio.ScanLines:按行分割(默认)
- bufio.ScanWords:按单词分割(空格分隔)
- bufio.ScanRunes:按Unicode字符分割
- bufio.ScanBytes:按字节分割
示例:按单词读取
Go |
自定义分割函数示例(按逗号分割):
Go |
为什么需要缓冲?举个简单对比:
- 无缓冲:每次写1字节,需要调用1次系统调用(如write()),1000次写入就是1000次系统调用。
- 有缓冲:先把1000字节写入内存缓冲区,满了后一次性调用1次系统调用刷盘,大幅减少系统调用次数。
测试结论:小数据量高频读写场景下,bufio比原生io快10-100倍。
- bufio是Go的缓冲I/O库,核心作用是减少系统调用、提升I/O性能,基于io.Reader/io.Writer封装。
- 核心组件:Reader(缓冲读取)、Writer(缓冲写入,必须调用Flush()刷盘)、Scanner(简化按块读取,默认按行)。
- 高频用法:ReadString('\n')按行读取、WriteString()写入字符串、Scanner.Scan()循环读取。
掌握bufio是Go处理文件、网络I/O的基础,日常开发中绝大多数I/O场景都应该优先使用bufio而非原生io。
|(注:文档部分内容可能由 AI 生成)
附件原文:onenote-go-bufio-Go_bufio_.docx(点击下载)
附件文档全文(Go io Read Write )#
Go 语言 io 包中 Read 和 Write 方法的本质差异解析
你想弄清楚Go语言io包中核心的Read和Write方法的本质区别,我会从核心语义、参数/返回值、执行逻辑、使用场景 四个维度,把这两个方法的差异讲透,同时补充新手容易混淆的细节。
Read和Write是io包中对立且互补的两个方法,核心语义的差异是:
维度 | Read(p []byte) | Write(p []byte) |
核心目的 | 从「数据源」(如文件、网络、内存)读取数据到用户提供的缓冲区p 中 | 将「用户提供的缓冲区p中的数据」写入到数据目标(如文件、网络、内存)中 |
数据流向 | 数据源 → 内存缓冲区p(外部→内部) | 内存缓冲区p → 数据目标(内部→外部) |
操作对象 | 读取「数据源」的内容,p是“接收容器” | 写入「数据目标」的内容,p是“待发数据” |
核心角色 | 你是“消费者”,从数据源拿数据 | 你是“生产者”,向目标送数据 |
两者的方法签名看似相似,但每个参数/返回值的含义和使用逻辑完全不同:
Go |
维度 | Read的p | Write的p |
作用 | 用于「接收」从数据源读取的数据 | 用于「提供」要写入到目标的数据 |
数据状态 | 调用前:p是空白/旧数据(会被覆盖);调用后:p[:n]是新读取的数据 | 调用前:p必须填充好要写入的数据;调用后:p内容不变(数据已被拷贝到目标) |
容量要求 | len(p)决定“最多能读取多少字节”(越大单次读取越多,但内存占用高) | len(p)决定“要写入的总字节数”(必须是已填充数据的长度) |
n都是「实际处理的字节数」,但含义完全不同:
维度 | Read的n | Write的n |
含义 | 实际从数据源读取到p中的字节数(0 ≤ n ≤ len(p)) | 实际从p中写入到目标的字节数(0 ≤ n ≤ len(p)) |
常见场景 | n < len(p) 是正常的(如数据源只剩5字节,但p长度是10) | n < len(p) 是异常的(表示写入失败,需返回非nil错误,如io.ErrShortWrite) |
特殊值 | n=0 通常伴随err=io.EOF(数据源读完) | n=0 通常伴随非nil错误(如写入权限不足) |
维度 | Read的err | Write的err |
正常结束 | err=io.EOF(数据源读取完毕) | err=nil(全部写入成功) |
部分成功 | 允许n>0且err=io.EOF(最后一次读取了部分数据,然后到末尾) | 不允许n>0且err=nil(若n<len(p),必须返回err) |
常见错误 | io.EOF、os.ErrNotExist(文件不存在)、网络断开 | os.ErrPermission(权限不足)、磁盘满、网络断开 |
Read的核心是“尽可能读,但不保证读满”,步骤:
- 检查数据源是否有数据(如文件指针是否到末尾、网络是否有数据);
- 从数据源读取数据,填充到p中,填充多少算多少(最多len(p)字节);
- 返回实际填充的字节数n,以及对应的错误(如io.EOF表示读完);
- 即使只填充了部分数据(n < len(p)),只要没到末尾且无错误,err也为nil。
示例:数据源只剩3字节,p长度为10
Go |
Write的核心是“尽可能写,写不满则报错”,步骤:
- 检查数据目标是否可写入(如文件是否可写、网络是否连通);
- 把p中的数据写入到目标,写入多少算多少;
- 如果全部写入(n=len(p)),返回n=len(p)、err=nil;
- 如果只写入部分(n < len(p)),必须返回n和非nil错误(如io.ErrShortWrite);
- 若完全写入失败(n=0),返回n=0和具体错误(如权限不足)。
示例:p长度为10,磁盘只剩5字节空间
Go |
因为Read不保证读满,必须循环读取直到io.EOF:
Go |
因为Write可能写不满,必须循环写入直到全部数据写完:
Go |
- “谁主动”的误区:
- 不是你“主动读”,而是Read方法把数据源的数据“填到”你的缓冲区;
- 不是你“主动写”,而是Write方法把你的缓冲区数据“拿走去”写入目标。
- 缓冲区所有权:
- Read的p是你的缓冲区,方法会修改它的内容;
- Write的p是你的数据,方法只会读取它的内容,不会修改。
- EOF的区别:
- Read会返回io.EOF(正常结束标记);
- Write永远不会返回io.EOF(写入目标没有“末尾”的概念)。
- 核心流向:Read是「数据源→缓冲区」(拿数据),Write是「缓冲区→目标」(送数据);
- 参数角色:Read的p是“接收容器”,Write的p是“待发数据”;
- 返回值逻辑:Read允许n<len(p)且err=nil,Write不允许;Read有io.EOF,Write无;
- 使用方式:两者都需循环调用,Read循环到EOF,Write循环到全部数据写入。
记住这两个方法的核心差异,就能正确处理Go中所有I/O场景,避免出现“读取不完整”“写入丢失数据”等常见问题。
|(注:文档部分内容可能由 AI 生成)
附件原文:onenote-go-bufio-Go_io_Read_Write_.docx(点击下载)
附件文档全文( Bufio )#
深入剖析 Bufio 的底层实现原理
你想深入了解bufio包的底层实现原理,我会从缓冲区结构、核心方法执行流程、性能优化的本质这几个维度,拆解bufio的底层逻辑,让你明白它“缓冲”的核心机制。
bufio的所有功能都基于内存缓冲区 + 对底层io.Reader/io.Writer的封装 实现,先看最核心的两个结构体(简化版):
Go |
- 缓冲区buf是一个固定大小的字节切片(默认4096字节,可通过NewReaderSize指定)。
- r和w是两个核心指针:
- 初始时r=0, w=0,缓冲区为空;
- 从底层读取数据时,数据被填充到buf[w:],然后w后移;
- 从缓冲区读取数据时,从buf[r:]取数据,然后r后移;
- 当r == w时,缓冲区为空,需要重新从底层读取数据填充。
Go |
- 缓冲区buf同样是固定大小的字节切片;
- n是写指针,指向缓冲区中下一个可写入的位置,初始为0;
- 当n == len(buf)时,缓冲区满,触发自动刷盘(调用Flush())。
bufio.Reader的核心逻辑是:优先从缓冲区读取数据,缓冲区空了再批量从底层Reader读取数据填充缓冲区,避免每次读取都调用底层IO。
以最常用的ReadString('\n')为例,拆解完整执行流程:
缓冲区为空(r=0, w=0),调用ReadString('\n')时,先检查缓冲区是否有数据。
因为缓冲区为空,调用reader.fill()方法从底层rd(如文件)批量读取数据:
Go |
- 一次读取最多填满整个缓冲区(如4096字节),而不是只读取1行/1字节;
- 这是性能优化的核心:用一次底层IO调用,换取多次内存读取。
填充缓冲区后,在buf[r:w]范围内查找换行符\n:
- 如果找到:截取buf[r:找到的位置+1]作为结果,然后r移动到“找到的位置+1”;
- 如果没找到:
- 先把当前缓冲区所有数据返回(作为临时结果);
- 再次调用fill()填充缓冲区;
- 重复查找,直到找到换行符或遇到EOF。
下次调用ReadString('\n')时,优先从缓冲区buf[r:w]读取,直到r == w(缓冲区空),才会再次调用fill()。
Peek(n int)是“预览”数据而不移动读指针,底层只是简单返回buf[r:r+n](不修改r),完全是内存操作,无任何IO开销。
bufio.Writer的核心逻辑是:优先写入到内存缓冲区,缓冲区满/手动Flush时,批量写入到底层Writer。
以WriteString(s string)为例,拆解流程:
调用WriteString时,先计算缓冲区剩余空间:free = len(buf) - n(n是当前已写入的字节数)。
- 如果字符串长度 ≤ free:直接把字符串拷贝到buf[n:n+len(s)],然后n += len(s);
- 如果字符串长度 > free:
- 先调用Flush()把当前缓冲区数据写入底层Writer;
- 如果字符串长度 > 缓冲区总大小(如写入10KB字符串,缓冲区4KB):直接把字符串写入底层Writer(避免多次拷贝);
- 否则:把字符串拷贝到空的缓冲区。
Flush()是Writer的核心方法,底层实现:
Go |
- Flush()的本质是:把缓冲区中buf[0:n]的所有数据,一次性写入底层wr;
- 未调用Flush()时,数据只存在于内存缓冲区,程序退出会丢失(这是新手最容易踩的坑)。
除了手动调用Flush(),Writer在以下场景会自动刷盘:
- 缓冲区满(n == len(buf));
- 调用Write/WriteString时,数据长度超过缓冲区剩余空间;
- Writer被关闭时(部分场景,如os.File的Close会触发Flush,但不依赖这个)。
Scanner是对bufio.Reader的封装,核心增加了“分割逻辑”,底层结构简化:
Go |
Scanner.Scan()的底层流程:
- 调用r.Read从缓冲区读取数据到buf;
- 调用split分割函数(如ScanLines)处理buf,分割出一个token(如一行);
- 把分割后的token缓存,通过Text()/Bytes()返回;
- 剩余未分割的数据保留在buf中,下次Scan()继续处理。
为什么bufio比原生io快?核心是减少系统调用次数:
- 原生io:每次Read/Write都会触发一次系统调用(如Linux的read()/write()),系统调用需要从用户态切换到内核态,开销大;
- bufio:
- 读取时:一次系统调用读取大量数据到内存缓冲区,后续读取都是内存操作;
- 写入时:多次内存写入缓冲区,一次系统调用刷盘到底层存储。
数据对比:
- 原生io写1000次1字节数据:触发1000次系统调用;
- bufio写1000次1字节数据:触发1次系统调用(缓冲区满后刷盘);
- 系统调用的开销是内存操作的1000+倍,这是bufio性能优势的根本原因。
bufio默认缓冲区大小是4096字节(4KB),这不是随便定的:
- 匹配操作系统的页大小(Linux/Windows默认页大小都是4KB),减少内存分页开销;
- 过小(如128字节):缓冲区频繁填满,系统调用次数增加;
- 过大(如64KB):内存占用增加,且单次系统调用读取的数据过多,可能导致内存浪费;
- 自定义场景:
- 小文件/高频小数据:用默认4KB;
- 大文件/批量数据:可设置8KB/16KB(不建议超过64KB)。
- bufio的核心是内存缓冲区 + 读写指针:Reader通过r/w指针管理缓冲区读取,Writer通过n指针管理缓冲区写入;
- 性能优化本质:用“一次底层IO + 多次内存操作”替代“多次底层IO”,减少用户态↔内核态的切换开销;
- 核心方法逻辑:
- Reader:缓冲区空→fill()填充→内存读取;
- Writer:内存写入→缓冲区满/Flush→批量刷盘;
- Scanner:基于Reader封装,增加分割逻辑简化读取。
理解这些底层原理后,你就能精准把控bufio的使用场景(如何时自定义缓冲区大小、何时手动Flush),避免踩坑(如Writer忘记Flush导致数据丢失)。
|(注:文档部分内容可能由 AI 生成)
附件原文:onenote-go-bufio-_Bufio_.docx(点击下载)
附件文档全文(io )#
io包详解
你想要详细了解Go语言标准库中io包的核心内容、设计思想和底层用法,我会从io包的定位、核心接口、常用函数、底层设计逻辑等维度,把这个Go I/O编程的“基础骨架”讲清楚,帮你理解io包是如何抽象和统一所有I/O操作的。
io包是Go语言所有I/O操作的基础抽象层,它不直接实现具体的I/O(如文件、网络、内存),而是定义了一套通用的、标准化的I/O接口(如Reader、Writer),以及基于这些接口的通用工具函数。
简单来说:
- io包的核心是接口定义 + 通用I/O工具;
- 所有具体的I/O实现(如os.File、net.Conn、bytes.Buffer)都遵循io包的接口规范;
- bufio、ioutil(Go 1.16后并入io/os)等包都是基于io接口的上层封装。
io包的灵魂是4个核心接口,几乎所有I/O操作都围绕它们展开,先看最核心的两个:
Go |
核心规则:
- Read方法会尽可能读取len(p)字节的数据,但不保证一定读满(这是新手最容易误解的点);
- 当读取到数据源末尾时,返回n=0和err=io.EOF(如果最后一次读取了部分数据,会先返回n>0和err=nil,下次调用才返回0, io.EOF);
- 即使返回了n>0,也可能同时返回err(如读取到末尾时,可能读了部分数据,同时返回io.EOF)。
简单实现示例(从字符串读取):
Go |
输出结果:
Plain Text |
Go |
核心规则:
- Write方法会尽可能写入len(p)字节的数据,若写入失败,返回n<len(p)和对应的错误;
- 如果n < len(p)且err == nil,这是不符合规范的(应返回io.ErrShortWrite错误);
- 写入成功时,n == len(p)且err == nil。
简单实现示例(写入到标准输出):
Go |
输出结果:
Plain Text |
3. 扩展接口:io.ReaderFrom / io.WriterTo
针对“从一个Reader读取并写入到另一个Writer”的高频场景,io包定义了更高效的扩展接口:
Go |
优势:相比手动循环Read+Write,这些接口的实现通常做了性能优化(如批量读写),比如os.File的ReadFrom会直接调用系统级的sendfile,避免用户态和内核态的拷贝。
接口 | 核心方法 | 用途 |
io.ReaderAt | ReadAt(p []byte, off int64) | 从指定偏移量读取数据(随机读取) |
io.WriterAt | WriteAt(p []byte, off int64) | 向指定偏移量写入数据(随机写入) |
io.Seeker | Seek(offset int64, whence int) | 调整读写指针位置(如文件的Seek) |
io.Closer | Close() error | 关闭I/O资源(如文件、网络连接) |
组合接口:io包还定义了常用的组合接口,比如:
Go |
io包提供了大量基于核心接口的通用工具函数,避免重复造轮子,高频使用的有:
Go |
核心优势:
- 自动处理缓冲区,无需手动循环Read/Write;
- 会利用ReaderFrom/WriterTo接口优化性能(如果实现了的话)。
示例:拷贝文件内容
Go |
Go |
示例:只拷贝前100字节
Go |
Go |
示例:读取文件全部内容
Go |
4. io.WriteString:写入字符串(简化Writer操作)
Go |
示例:
Go |
5. io.Pipe:创建管道(内存中连接Reader和Writer)
Go |
示例:
Go |
io包的设计是Go“面向接口编程”的典范:
- 不关心数据源/目标是什么(文件、网络、内存、字符串),只关心是否实现了Reader/Writer接口;
- 只要实现了接口,就能无缝使用io包的所有工具函数(如Copy、ReadAll);
- 比如:strings.Reader(字符串)、bytes.Buffer(内存)、os.File(文件)、net.Conn(网络连接)都实现了Reader/Writer,可以互相替换使用。
io包的核心接口只有一个方法(如Read/Write),遵循“最小接口原则”:
- 接口越小,越容易实现;
- 组合接口(如ReadWriter)只是多个基础接口的组合,不增加新方法;
- 比如:你只需要实现Read方法,就能让自定义类型成为Reader,无需实现其他方法。
io包的原生接口(如Read/Write)是无缓冲的:
- 每次调用Read/Write都会直接触发底层I/O操作(如系统调用);
- 这也是为什么bufio包需要存在:在io接口之上增加缓冲区,减少底层I/O调用次数。
Read方法的返回值n可能小于len(p),这是合法的(比如数据源只剩少量数据),正确的读取方式是循环读取:
Go |
Write可能只写入部分数据(返回n < len(p)),必须检查返回值:
Go |
实现了io.Closer接口的类型(如os.File、net.Conn),必须调用Close()释放资源,建议用defer:
Go |
- io包是Go I/O编程的基础,核心是定义了Reader/Writer等通用接口,以及基于这些接口的工具函数;
- 核心设计思想:面向接口编程、最小接口原则、无缓冲原生I/O;
- 高频工具函数:io.Copy(数据拷贝)、io.ReadAll(读取全部数据)、io.WriteString(写入字符串);
- 关键注意点:Read不一定读满缓冲区,Write可能只写入部分数据,必须循环处理;实现Closer的资源要记得关闭。
理解io包是掌握Go所有I/O操作的基础,bufio、net、os等包的I/O功能都是基于io接口实现的,掌握了io包的核心思想,就能举一反三理解其他I/O相关包。
|(注:文档部分内容可能由 AI 生成)
附件原文:onenote-go-bufio-io_.docx(点击下载)
转换文字版(供搜索 / 复制)
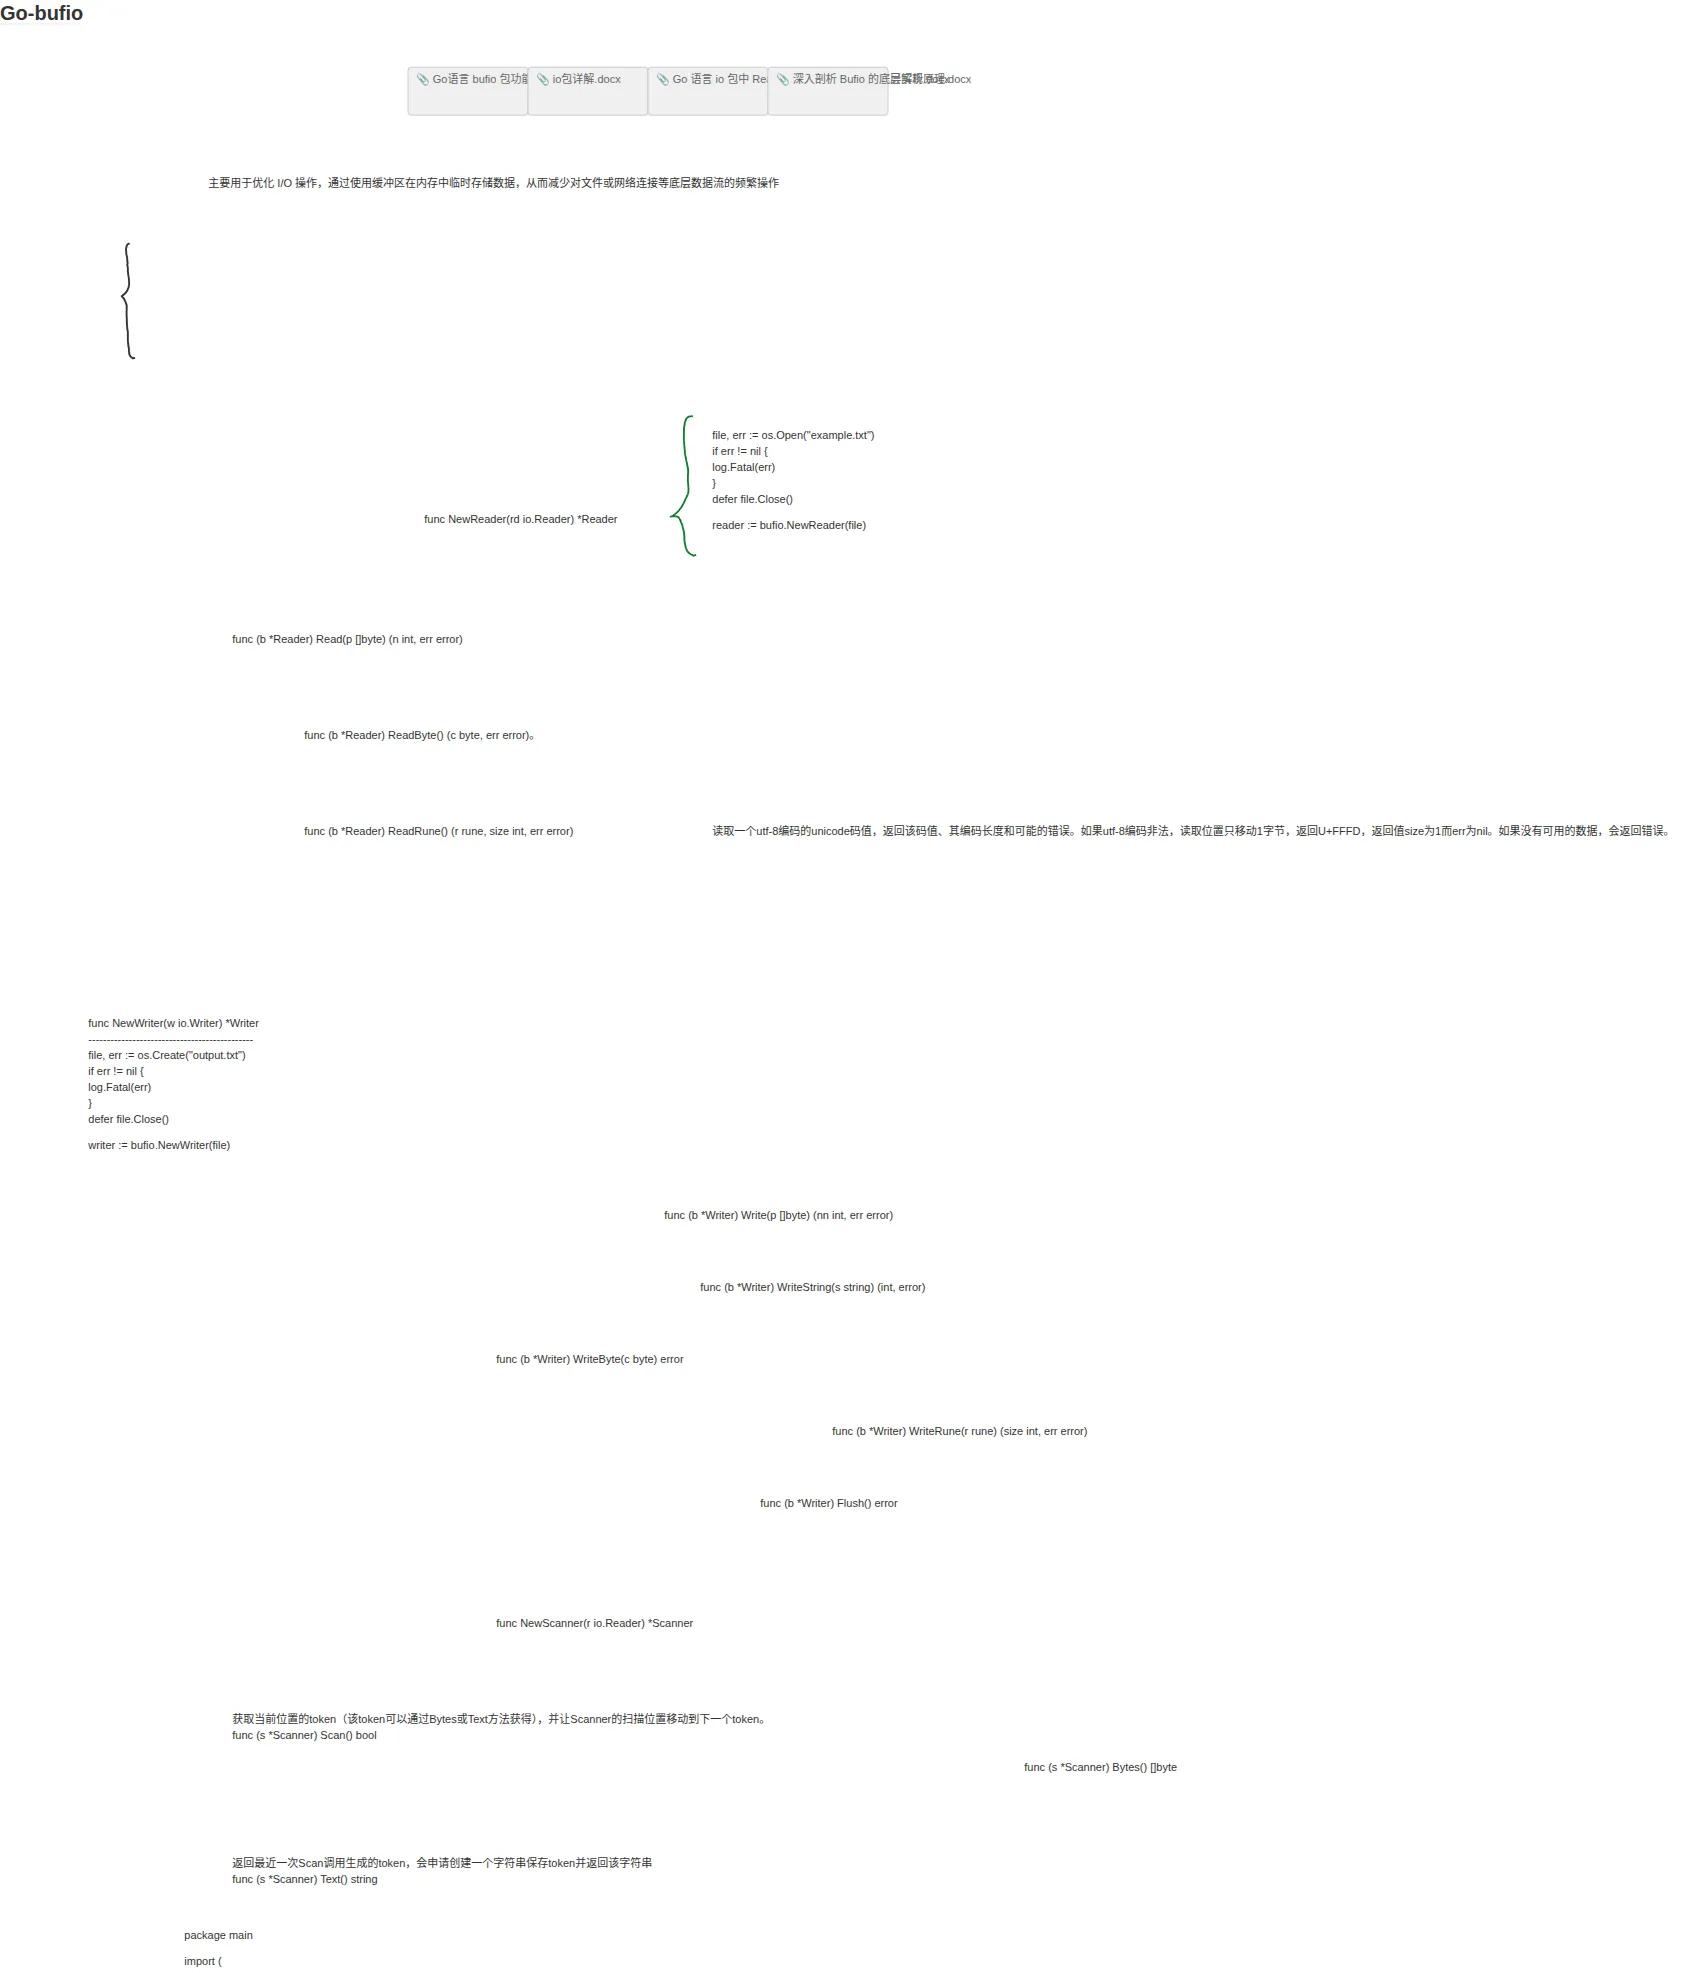
主要用于优化 I/O 操作,通过使用缓冲区在内存中临时存储数据,从而减少对文件或网络连接等底层数据流的频繁操作
file, err := os.Open("example.txt")
if err != nil {
log.Fatal(err)
}
defer file.Close()
reader := bufio.NewReader(file)
func NewReader(rd io.Reader) *Reader
func (b *Reader) Read(p []byte) (n int, err error)
func (b *Reader) ReadByte() (c byte, err error)。
func (b *Reader) ReadRune() (r rune, size int, err error)
读取一个utf-8编码的unicode码值,返回该码值、其编码长度和可能的错误。如果utf-8编码非法,读取位置只移动1字节,返回U+FFFD,返回值size为1而err为nil。如果没有可用的数据,会返回错误。
func NewWriter(w io.Writer) *Writer
---------------------------------------------
file, err := os.Create("output.txt")
if err != nil {
log.Fatal(err)
}
defer file.Close()
writer := bufio.NewWriter(file)
func (b *Writer) Write(p []byte) (nn int, err error)
func (b *Writer) WriteString(s string) (int, error)
func (b *Writer) WriteByte(c byte) error
func (b *Writer) WriteRune(r rune) (size int, err error)
func (b *Writer) Flush() error
func NewScanner(r io.Reader) *Scanner
获取当前位置的token(该token可以通过Bytes或Text方法获得),并让Scanner的扫描位置移动到下一个token。
func (s *Scanner) Scan() bool
func (s *Scanner) Bytes() []byte
返回最近一次Scan调用生成的token,会申请创建一个字符串保存token并返回该字符串
func (s *Scanner) Text() string
package main
import (
"bufio"
"fmt"
"os"
)
func main() {
file, err := os.Open("example.txt")
if err != nil {
fmt.Println("Error opening file:", err)
return
}
defer file.Close()
scanner := bufio.NewScanner(file)
for scanner.Scan() {
line := scanner.Text() // 读取一行数据
fmt.Println(line)
}
if err := scanner.Err(); err != nil {
fmt.Println("Error reading file:", err)
}
}